3장. AI 시대, 인간이 한번도 접해보지 못했던 접근방법으로 데이터는 자산이 된다.
 Sean, CHO이매진팩토리조성원생성형AI기업AX암묵지RAGLLM이매진팩토리조성원
내 컴퓨터가 내 말을 알아듣기를 바라던 시절 나는 나름 얼리어답터였다.
1999년에는 HP PDA에 CDMA 툴킷을 꽂아 휴대전화처럼 들고 다녔다.
지금 생각하면 손바닥만 한 기계에 안테나를 달아놓고 미래를 산다고 우긴 셈이다.
그래도 그때는 제법 근사했다.
주머니에서 기계를 꺼내면 주변 사람들이 한 번씩 쳐다봤다. 그 시선이 좋았다.
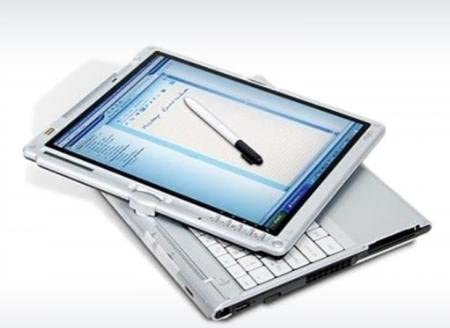
2006년 컨설팅을 할 때는 후지쯔의 라이프북 T4220 태블릿 PC를 썼다.
평소에는 노트북처럼 썼다.
회의 중에 화면을 휙 돌려 맞은편 클라이언트에게 보여주면, 다들 잠깐 멈췄다.
“그게 되는 거예요?”라는 표정이었다. 거기서 끝이 아니다.
화면을 접으면 태블릿이 됐다. 펜을 꺼내 화면에 손글씨로 메모를 하면,
다들 신기해했다. 그 시선이 좋았다.
2006년 무렵 사용했던 Fujitsu Lifebook T4220.
당시에는 화면을 접고 펜으로 쓰는 일만으로도 회의실의 공기가 잠깐 달라졌다.
그렇게 최신 기기를 들고 다니면서도 내게는 아주 구식인 문제가 하나 있었다.
파일을 찾는 일이었다.
컨설팅 프로젝트가 하나 끝날 때마다 폴더가 생겼다.
제안서, 인터뷰 노트, 워크숍 자료, 회의록,
엑셀 파일, 분석 결과, 보고서 초안, 수정본, 진짜 최종본, 진짜 진짜 최종본. 폴더 구조는 나름 잘 만들었다.
당시의 나는 폴더를 잘 정리하는 사람이 일을 잘하는 사람이라고 믿었다.
인간은 가끔 폴더 구조에서 자기 통제력을 확인한다.
그런데 시간이 흐르면 문제가 생긴다.
삼성에서 했던 프로젝트 중에 예측모델을 만들었던 일이 있었다. 분명 자료를 만들었다.
그런데 어느 폴더에 있었는지 기억이 나지 않는다. 프로젝트명은 기억나는데, 당시 보고서 제목은 기억나지 않는다. “예측모델”이라는 단어가 들어갔는지도 자신이 없다. (정확히는 내 로컬 PC 안에서만 정리했을때는 기가막히게 정리해서 금방 찾았는데, Drop Box , Google Drive 등 클라우드가 등장하면서 로컬과 클라우드가 혼재되는 시절 부터는 나도 헛갈리기 시작했다) 그때 이런 생각을 했다.
“삼성에서 했던 컨설팅 중에, World Wide M/S 예측모델을 만든 프로젝트 자료 좀 찾아줘.”
컴퓨터가 이렇게 알아들으면 얼마나 좋을까? 파일 이름을 정확히 기억하지 않아도 되고, 폴더를 하나씩 열어볼 필요도 없고, 내가 무엇을 하려는지 맥락까지 알아서 찾아주면 말이다.
한 술 더 떠서, 내가 찾으려는 자료를 말로 꺼내기도 전에 먼저 보여주면 좋겠다고 생각했다.(뉴럴링크처럼 말이다)
방법은 짐작하고 있었다. 컴퓨터가 내 파일을 한 번 다 읽고, 내용과 맥락에 따라 색인을 달아두면 된다.
하지만 그 많은 자료를 누가 읽는가. 누가 “이 파일은 삼성, 예측모델, 제조, 2004년, 워크숍”이라고 꼬리표를 붙이는가.
결국 나는 가장 인간적인 해결책으로 돌아갔다.
폴더를 더 열심히 정리했다. 그때는 그것이 최선이었다.
지금은 아니다. 파일을 찾는 방식이 바뀌면, 지식의 운명도 바뀐다 예전의 정보 검색은 대체로 두 가지였다.
계층을 따라 내려가거나, 키워드를 맞추거나. 우리는 폴더를 열고 또 열었다.
아니면 기억나는 단어를 검색창에 넣었다. 둘 다 기억력이 좋아야 한다.
파일을 만든 사람의 기억력 말이다. 그래서 조직의 자료실은 대개 이상한 곳이 된다.
자료는 산더미인데, 필요한 자료는 찾기 어렵다. 정리하지 않은 사람만 탓할 일도 아니다.
당시의 도구가 사람에게 그렇게 일하라고 요구했기 때문이다.
문서를 만들 때부터 나중에 찾을 키워드를 정확히 예상해야 했다.
미래의 내가 무엇을 물어볼지, 과거의 내가 미리 알아야 했다.
꽤 무리한 부탁이다. (나는 이게 다 윈도우 탐색기 때문이라고 생각한 적도 있었다.)
생성형 AI와 대규모 언어모델 LLM이 바꾼 것은 단지 문장을 잘 쓰는 능력이 아니다.
더 중요한 변화는 ‘문맥으로 정보를 찾는’ 일이 가능해졌다는 데 있다.
여기서 자주 등장하는 기술이 RAG(Retrieval-Augmented Generation)다.
이름은 조금 거창하다. 쉽게 말하면 이렇다.
회사의 문서, 보고서, 매뉴얼, 연구노트, 회의록, 이미지 속 텍스트까지 읽을 수 있는 자료를 미리 연결해둔다.
누군가 질문하면 AI는 기억에만 의존해 그럴듯한 답을 만들어내는 대신, 먼저 그 자료들 속에서 관련 근거를 찾는다.
그리고 찾은 근거를 바탕으로 답한다.
그러니 질문은 더 이상 파일명 맞히기 시험이 아니다.
“지난 5년 동안 A 제품의 불량 원인으로 가장 자주 언급된 것은 무엇이었나?”
“해외 고객이 반복해서 불편하다고 말한 배송 경험은 무엇이었나?” “
우리 연구팀이 예전에 검토했지만 채택하지 않았던 대안은 무엇이었나?”처럼 물을 수 있다.
물론 AI가 갑자기 전지전능해지는 것은 아니다.
근거가 부실하면 답도 부실하다.
오래된 문서, 서로 충돌하는 기준, 출처 없는 숫자는 AI를 만나도 갑자기 진실이 되지 않는다.
오히려 그 반대다. AI를 붙이면 조직 안에 쌓여 있던 혼란이 더 선명하게 드러난다.
아주 성실하게 틀린 답을 만들어낼 수도 있다. 그러니 출처를 확인하고,
답이 어느 문서에서 왔는지 추적할 수 있게 설계해야 한다.
그럼에도 변화의 크기는 작지 않다.
이제 연구 데이터, 생산 이력, 구매 기록, 품질 보고서, 마케팅 캠페인 자료, 고객 상담 내용처럼
수십 년 동안 쌓여온 흔적들이 다시 말을 걸 수 있다. 예전에는 폴더 안에서 잠자던 자료였다.
이제는 질문에 반응하는 지식 후보가 된다.
데이터 자산은 데이터를 많이 모아둔 창고가 아니다.
필요한 순간에 맥락과 근거를 갖고 다시 쓸 수 있는 데이터.
그것이 데이터 자산이다.
암묵지는 원래 말이 없었다 조직에는 늘 ‘그 사람만 아는 것’이 있다.
생산 현장에는 기계를 소리만 듣고도 이상을 알아채는 사람이 있다.
구매 부서에는 거래처 담당자의 말투만으로 납기 위험을 감지하는 사람이 있다.
연구소에는 실패한 실험의 진짜 이유를 노트 어딘가에 적어둔 사람이 있다.
영업 조직에는 고객이 회의에서 고개를 끄덕였다고 해서 계약할 생각이 있는 것은 아니라는 사실을 몸으로 아는 사람이 있다.
(이런것이 앞에서 언급한 Semantic Code 로만 존재하는것들인데, 심지어 Digital Code 로 자기만 알아보게 만든다는 말이다)
이런 능력은 대개 문서 한 장으로 옮겨지지 않는다.
그래서 ‘암묵지’라고 부른다.
말로 설명하기 전에 몸이 먼저 아는 지식이다. 그 자체로는 귀하다.
문제는 그것이 한 사람의 머릿속, 개인 노트북, 자기만 알아볼 수 있는 엑셀 파일에만 갇혀 있을 때다.
그때 조직의 성과는 개인 역량을 닮는다.
일을 가장 잘 아는 사람에게 일이 몰리고, 그 사람이 없으면 회의가 미뤄진다.
그 사람이 휴가를 가면 의사결정도 함께 휴가를 간다.
처음에는 ‘핵심 인재’라고 부른다. 시간이 조금 더 지나면 ‘병목’이 된다.
그 사람도 억울할 수 있다. 자기가 잘해서 일이 몰렸는데, 어느 날 회사가 “왜 당신만 아느냐”고 묻기 때문이다.
그러나 솔직히 말해 조직도 그 사람도 이 구조에 익숙해져 있는 경우가 많다.
“나 없으면 안 되지?”라는 감각은 생각보다 달콤하다.
누군가를 대체 불가능하게 만드는 것은 때로 실력이고, 때로는 파일명 규칙을 아는 사람 한 명뿐이라는 사실이다.
이 문제는 개인의 성격 문제가 아니다. 조직 설계의 문제다. 지식이 개인에게만 쌓이도록 일하는 방식을 방치한 결과다.
이를 위해서는 최소한 네 가지가 필요하다.
첫째, 흔적을 남겨야 한다. 중요한 의사결정은 무엇을 선택했는지만 남기지 말고,
왜 그렇게 선택했는지와 무엇을 포기했는지도 남겨야 한다.
실패한 실험도 마찬가지다. 실패 데이터는 회사의 흑역사가 아니다.
다음 사람이 같은 벽에 머리를 박지 않게 하는 비용 절감 장치다.
둘째, 맥락을 붙여야 한다.
데이터에는 날짜와 담당자만큼이나 업무 목적, 적용 조건, 고객 상황, 판단 기준이 중요하다.
숫자만 남은 데이터는 설명을 기다리는 숫자일 뿐이다.
맥락이 붙어야 다른 사람이 다시 써볼 수 있다.
셋째, 출처를 추적할 수 있어야 한다.
AI가 답을 내놓았을 때 “그건 어디에 근거한 말인가?”를 물을 수 있어야 한다.
이 질문에 답하지 못하는 AI는 똑똑한 동료가 아니라 말 많은 인턴에 가깝다.
조직의 데이터 자산은 화려한 답변보다 검증 가능한 근거에서 시작한다.
넷째, 앞 장에서 말한 Data Thread로 연결해야 한다.
연구의 가설, 구매의 판단, 생산의 조건, 품질의 결과, 물류의 이슈, 고객의 반응이 따로따로 남아 있으면
AI도 부서별 비서에 머문다. 연결되면 비로소 질문의 수준이 달라진다.
“이 품질 이슈는 어느 공급 조건과 함께 나타났는가?”
“이 고객 불만은 생산, 배송, 사용 단계 중 어디에서 시작되었는가?” 같은 질문이 가능해진다.
개인의 암묵지는 그 사람의 경쟁력이다.
하지만 조직과 연결된 암묵지는 회사의 경쟁력이 된다.
데이터 자산은 ‘정리’가 아니라 ‘재사용’에서 완성된다
많은 회사가 데이터 자산화라고 하면 대규모 시스템부터 떠올린다.
전사 데이터 플랫폼, 거대한 데이터 레이크, 최신 벡터 데이터베이스, 조직도만큼 복잡한 권한 체계. 물론 필요한 일이다.
그러나 시스템부터 크게 만들면 현장은 곧 묻는다.
“그래서 이걸로 오늘 무엇을 할 수 있습니까?” 정확한 질문이다.
데이터 자산화는 IT 프로젝트가 아니라 일하는 방식의 변화다.
시작점은 거창한 플랫폼이 아니라, 반복해서 발생하는 중요한 질문이어야 한다.
예를 들면 이렇다. 숙련자가 퇴직해도 같은 품질 판단을 할 수 있는가?
신규 영업 담당자가 과거의 고객 맥락을 하루 안에 이해할 수 있는가?
연구원이 예전 실패와 검토 이력을 찾아 같은 시행착오를 줄일 수 있는가?
프로젝트가 끝난 뒤 얻은 통찰이 다음 프로젝트의 출발점이 되는가?
이 질문에 “아마 담당자에게 물어봐야 할 것 같습니다”라고 답해야 한다면, 아직 자산이 아니다.
자료가 있을 뿐이다. 처음부터 모든 문서를 AI에 넣을 필요도 없다.
가장 자주 묻고, 가장 자주 막히며, 잘못 판단했을 때 비용이 큰 영역 하나부터 시작하면 된다.
예를 들어 품질 이슈 대응 기록, 핵심 고객의 제안과 협상 이력, 연구개발의 실험 노트처럼 조직의 성과를 크게 좌우하는 지식부터 고른다. 자료를 정리하고, 필요한 맥락을 붙이고, 출처를 확인할 수 있게 한 뒤, 실제 현장 질문으로 테스트한다.
답이 별로면 AI 탓만 할 일이 아니다. 무엇이 빠졌는지, 어떤 맥락이 부정확했는지,
왜 서로 다른 부서의 언어가 연결되지 않았는지를 살펴봐야 한다. 이
과정에서 데이터의 품질도 좋아지고, 일하는 방식도 드러난다.
AI는 조직의 지식을 자동으로 만들어주지 않는다.
다만 그동안 아무도 다시 꺼내지 못했던 경험과 흔적을, 질문할 수 있는 자리에 데려다 놓는다.
그래서 AI 시대의 데이터 자산은 이렇게 정의할 수 있다.
데이터 자산은 저장된 파일의 양이 아니다.
조직이 과거의 경험을 근거로 오늘의 질문에 답하고, 내일의 판단을 더 잘하게 만드는 능력이다.
예전의 나는 폴더를 정리했다.
지금의 조직은 경험을 연결해야 한다.
그 차이가 한 사람의 유능함을 회사의 유능함으로 바꾼다.
1장. AI 시대, 데이터를 보는 새로운 관점 보기
https://imaginefactory.ai/articles/ai-%EC%8B%9C%EB%8C%80-%EB%8D%B0%EC%9D%B4%ED%84%B0%EB%A5%BC-%EB%B3%B4%EB%8A%94-%EA%B4%80%EC%A0%90%EC%97%90-%EB%8C%80%ED%95%B4-a-new-way-to-see-data-in-the-age-of-ai
2장. AI시대, 데이터분석의 종말은 오는가? 보기
https://imaginefactory.ai/articles/ai%EC%8B%9C%EB%8C%80-%EB%8D%B0%EC%9D%B4%ED%84%B0%EB%B6%84%EC%84%9D%EC%9D%98-%EC%A2%85%EB%A7%90%EC%9D%80-%EC%98%A4%EB%8A%94%EA%B0%80-is-the-end-of-data-analytics-near
댓글 0
첫 댓글을 남겨주세요.