사람은 3분을 틀리고, AI는 3시간을 틀립니다.
 HJ, ChoiAIAX / DXConsulting이매진팩토리최혁준
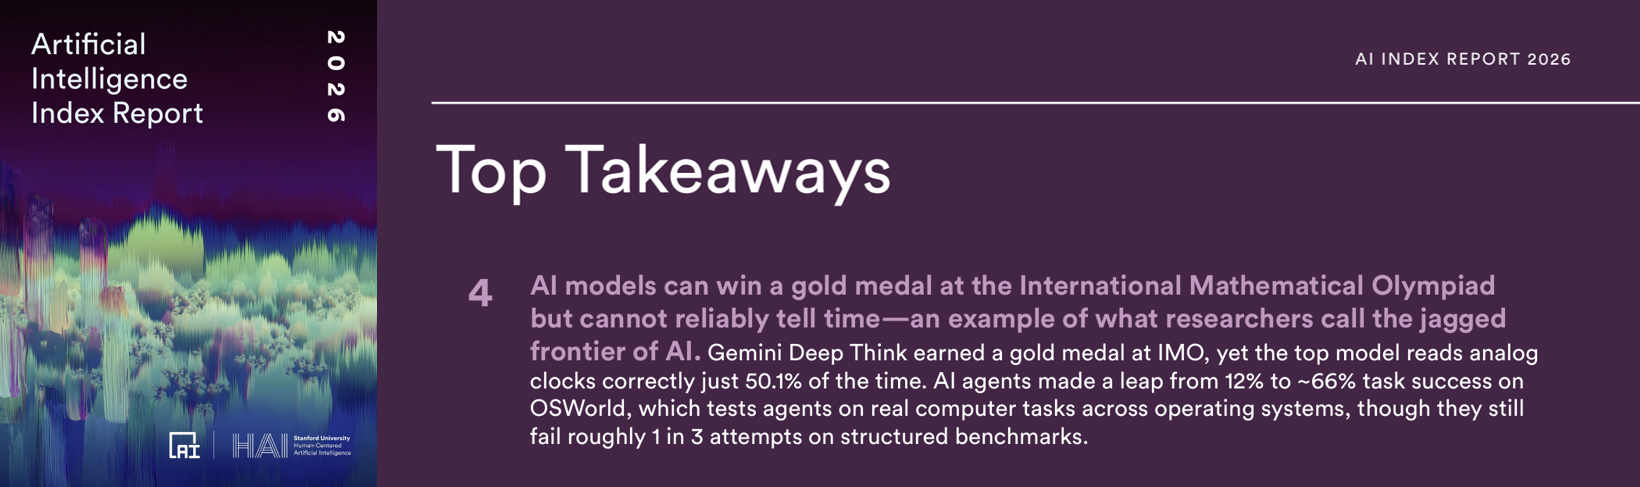
국제수학올림피아드에서 금메달을 딴 AI가, 정작 시계는 두 번에 한 번 밖에 제대로 보지 못합니다.
더 눈에 띄는 건 틀렸을 때입니다.
사람이 시계를 잘못 보면 보통 3분쯤 어긋나는데, AI는 1시간에서 3시간씩 어긋납니다.
스탠퍼드 HAI(Stanford Institute for Human-Centered Artificial Intelligence)가 2026년 4월 내놓은
The 2026 AI Index Report 에서 확인할 수 있는 숫자와 내용입니다.
여기서 우리는 AI Agent를 업무에 활용하려는 기업들에게 한 가지를 되묻게 만듭니다.
우리가 지금까지 던져온 질문이 과연 맞았을까요?
함께 읽으면 좋은 이매진팩토리Articles
• AI 에이전트가 직원보다 6배 더 일한다 — 에이전트가 실제 조직에서 얼마나 많은 일을 하고 있는지
• 피부자극반응(홍반) AI 판독모델 개발 및 운영 — AI가 배울 ’정답’이 맞는지 현장에서 검증한 사례
1. 금메달을 딴 AI가 벽시계를 못 읽는다.
2025년 국제수학올림피아드에서 Google DeepMind의 Gemini Deep Think는 4.5시간 제한 안에
사람과 똑같이 자연어로 문제를 풀어 35점을 받았습니다. 금메달입니다. 1년 전에는 28점으로 은메달이었습니다.
비슷한 시기, 다른 시험에서는 이런 결과가 나왔습니다.
ClockBench에서 최고 모델이 아날로그 시계를 제대로 읽은 비율은 50.6%였습니다. 사람은 90.7%입니다.
- ClockBench란?
시계 그림을 보여주고 “지금 몇 시입니까”를 묻는 평가입니다. 시계 디자인 180종에 질문 720개로 구성돼 있고,
검은 문자판이나 초침 없는 시계처럼 생김새를 조금씩 바꿔가며 묻습니다.
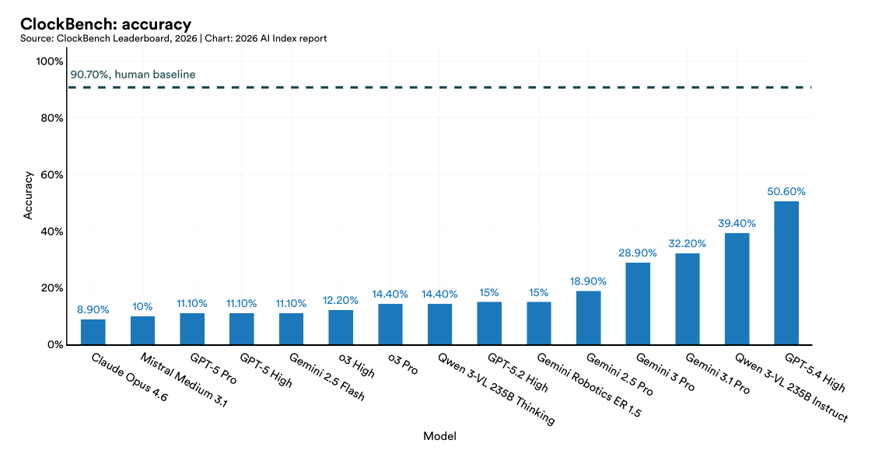
위쪽 점선이 사람의 성적(90.70%)입니다. 막대 15개 중 어느 것도 그 근처에 가지 못했습니다.
보고서는 이 현상에 이름을 붙였습니다. 울퉁불퉁한 프런티어(jagged frontier).
- 울퉁불퉁한 프런티어(jagged frontier)란?
AI가 잘하는 일과 못하는 일의 경계선이 매끄러운 곡선이 아니라 들쭉날쭉하다는 뜻입니다.
어떤 봉우리는 사람보다 한참 높은데, 바로 옆 골짜기는 초등학생 수준입니다.
그리고 그 봉우리와 골짜기는 우리가 생각하는 난이도 순서대로 놓여 있지 않습니다.
정리하면 이렇습니다. 사람에게 어려운 일과 AI에게 어려운 일은 서로 다릅니다.
2. 진짜 문제는 ‘잘 못한다’ 가 아니라 ’어떻게 틀리는가’ 이다.
여기까지는 흔히 듣는 이야기입니다. AI도 못하는 게 있다는 말이니까요.
그런데 보고서에서 정말 눈에 띄는 대목은 정답률이 아니었습니다.
모델이 시간을 틀리게 말할 때 오차의 중앙값은 약 1~3시간이었던 반면,
사람은 3분이었다는 점이였습니다. 사람도 시계를 틀립니다. 열 번에 한 번쯤은 틀립니다.
다만 2시 37분을 2시 40분으로 읽는 식입니다. 사람의 실수는 정답 근처에 머뭅니다.
AI는 같은 시계를 5시쯤으로 읽습니다. AI는 정답 근처가 아니라 아예 다른 자리입니다.
이 차이가 왜 중요할까요. 또한 어떠한 경우에는 AI가 내놓은 결과의 값이 완전히 달라도
문장이 매끄럽고 근거까지 붙어 있어 읽는 사람 입장에서는 틀린 티가 나지 않습니다.
왜 이런 실수가 반복될까
연구진이 시계 그림 5,000장을 따로 학습시켜 봤습니다.
익숙한 모양의 시계는 잘 맞혔지만, 실제로 찍은 사진이나 문자판이 조금 다른 시계는 여전히 틀렸습니다.
이유는 이렇습니다.
시계를 읽는 일은 한 번에 끝나지 않습니다.
먼저 어느 쪽이 시침이고 어느 쪽이 분침인지 가리고, 그 바늘이 가리키는 위치를 재고, 그걸 시간으로 바꿉니다.
첫 단계에서 시침과 분침을 바꿔 보면 그 뒤가 전부 따라서 틀립니다.
오차가 3분이 아니라 3시간이 되는 이유입니다.
그리고 이건 시계만의 이야기가 아닙니다.
기업 업무 대부분이 같은 모양입니다.
상황을 읽고, 기준을 적용하고, 결과를 다음 사람에게 넘깁니다. 첫 단추가 어긋나면 나머지가 전부 어긋납니다.
3. 66.3%라는 숫자를 읽는 두 가지 방법
보고서에 아래와 같은 그래프가 있습니다.
컴퓨터를 직접 조작하는 과제에서 AI가 받은 성적입니다.
OSWorld란, Windows, macOS, Ubuntu에서 앱을 열고 파일을 정리하는 식으로,
사람이 컴퓨터 앞에서 하는 일 369가지를 AI에게 그대로 시켜보는 평가입니다.
컴퓨터공학 전공 학생은 이 중 약 72%를 평균 2분 만에 해냅니다.
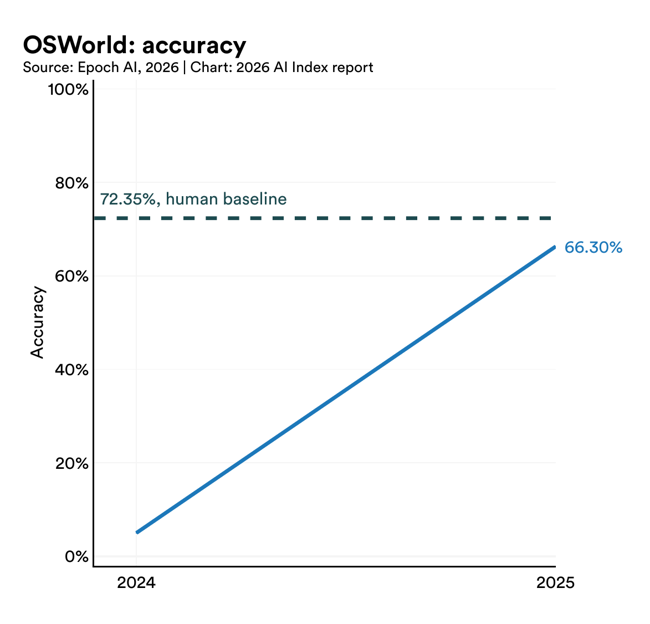
같은 그래프를 두 가지로 읽을 수 있습니다. 그리고 둘 다 맞습니다.
첫 번째 읽기: 선의 기울기를 본다
1년 전만 해도 최고 모델이 12%를 넘기지 못했습니다. 지금은 66.3%입니다.
다른 과제도 비슷합니다. 사이버보안 문제 풀이는 15%에서 93%로, 웹 작업은 15%에서 74.3%로 올라왔습니다.
컴퓨터 조작만 봐도 2025년 9월 Claude Sonnet 4.5가 61.4%였고,
몇 달 뒤 Claude Opus 4.5가 66.3%를 기록했습니다. 분기가 아니라 달 단위로 움직입니다.
여기서 얻는 결론은 이렇습니다. “지금은 AI가 못 한다”는 판단에는 유효기간이 있다는 것입니다.
올해 안 될 것 같다고 접는 과제를 내년에도 안 될 것으로 가정하면, 그 가정 자체가 먼저 틀린 것 입니다.
두 번째 읽기: 점선과의 거리를 본다
위쪽 점선이 사람의 성적(72.35%)입니다. 6%포인트 차이니 거의 따라잡은 것처럼 보입니다.
그런데 보고서는 같은 결과를 이렇게 적었습니다.
“에이전트는 2025년에 질문에 답하는 단계에서 작업을 완수하는 단계로 나아갔지만,
구조화된 벤치마크에서는 여전히 시도의 약 3분의 1에서 실패합니다.”
전공생이 2분 만에 끝내는 일을 세 번 중 한 번 실패한다는 뜻입니다.
게다가 ’구조화된’이라는 단서가 붙어 있습니다.
OSWorld는 369개 과제가 미리 정해져 있고 정답을 기계가 확인할 수 있는 환경입니다.
실제 회사 업무는 그보다 훨씬 덜 정돈돼 있습니다. 요청은 모호하고, 예외는 많고, 정답은 담당자마다 다릅니다.
그럼 더 좋은 모델을 기다리면 될까
타우벤치(τ-bench)가 그 질문에 답합니다.
소매나 항공처럼 규칙과 데이터가 얽힌 상황에서, 여러 번 대화를 주고받으며 일을 끝내게 하는 평가입니다.
상위 7개 모델이 62.9%에서 70.2% 사이에 몰려 있고, 71%를 넘은 모델은 하나도 없습니다.
- 타우벤치(τ-bench)란? AI를 고객 상담원 자리에 앉혀 보는 평가입니다. 한쪽에는 고객, 다른 쪽에는 회사 데이터베이스와 사규를 두고 항공권 변경 같은 일을 끝내게 합니다. 대화가 매끄러웠는지가 아니라, 끝난 뒤 데이터베이스가 제대로 바뀌었는지로 채점합니다.
세무나 법률 같은 전문 영역도 비슷합니다. 성적은 60~90%인데 상위 15개 모델의 차이가 3%포인트밖에 안 됩니다.
남은 격차를 모델의 성능 향상만으로 해결할 수는 없습니다.
모델의 발전과 함께, 그 모델을 둘러싼 업무 구조도 바뀌어야 합니다.
4. 그래서 질문을 바꿔야 한다
지금 회의실에서 많이 나오는 질문은 “AI가 이 업무를 할 수 있습니까?”입니다.
울퉁불퉁한 프런티어는 이 질문이 반쪽짜리라고 말합니다.
함께 물어야 할 질문이 하나 더 있습니다. “이 업무에서 AI는 어떻게 틀립니까?”
하나. 평균 정확도만 보고 결정하지 않는다
66%는 “열 번 중 예닐곱 번은 해준다”는 뜻이 아닙니다.
“나머지에 무슨 일이 벌어질지 모른다”에 가깝습니다.
시계 사례가 보여줬듯, 그 나머지가 정답 근처에 있으리라는 보장이 없습니다.
그래서 봐야 할 것이 하나 더 있습니다.
틀렸을 때 얼마나 크게 틀리는지, 그리고 그 정도를 업무가 감당할 수 있는지입니다.
둘. 사람 기준으로 업무를 쪼개지 않는다
“이건 단순 작업이니까 AI한테 맡기자.”
AX 현장에서 가장 자주 나오고, 가장 자주 틀리는 판단입니다.
모델들은 기업 재무나 법률 추론에서 60~90%를 기록하는데, 시계 읽기는 50%입니다.
쉬워 보이는 일이 AI에게도 쉬운 건 아닙니다.
업무를 쪼개는 기준은 우리 직관이 아니라 실제로 돌려본 결과여야 합니다.
셋. 틀릴 것을 전제로 업무 흐름을 만든다
우리는 AX 과제에서 완결성과 완비성을 이야기해왔습니다. 쉽게 풀면 이렇습니다.
• 완결성: 맡긴 일이 중간에 멈추지 않고 끝까지 마무리되는가
• 완비성: 그 마무리에 필요한 정보와, 일이 어긋났을 때의 대처가 미리 준비돼 있는가
울퉁불퉁한 프런티어는 여기에 질문 세 개를 더합니다.
• 틀렸을 때 누가 발견합니까
• 틀린 결과가 다음 단계로 넘어가기 전에 걸러집니까
• 값이 크게 벗어날 수 있다는 전제로, 범위를 확인하는 절차가 흐름 안에 있습니까
결국 바꿔야 할 건 한 줄입니다. 앞의 질문은 AI에 대한 것이고, 뒤의 질문은 우리 업무에 대한 것입니다.
“AI가 이 업무를 할 수 있습니까?”에서 “이 업무에서 AI가 틀리면, 누가 언제 발견합니까?”로.
끝으로
내년 이맘때면 이 글의 숫자는 대부분 바뀌어 있을 겁니다.
1년 만에 12%에서 66%로 올라온 기술이니까요. 50.6%짜리 시계 읽기도 언젠가는 해결될 겁니다.
그래도 바뀌지 않는 게 하나 있습니다.
AI가 잘하는 일과 못하는 일의 경계는, 우리가 짐작하는 자리에 있지 않습니다.
그리고 그 경계는 해마다 다시 그어집니다.
경계를 직접 확인해 본 조직과 짐작으로 넘긴 조직의 차이는, 어떤 모델을 쓰느냐의 차이보다 큽니다.
앞의 조직은 AI가 어디서 넘어지는지 알고 그 자리에 사람을 둡니다.
뒤의 조직은 평균 정확도를 믿고 맡겼다가, 3분짜리가 아니라 3시간짜리 오류를 뒤늦게 발견합니다.
상상할 수 있는 만큼 혁신할 수 있습니다. 지금의 한계를 뛰어넘을 수도 있습니다.
중요한 것은 AI가 무엇을 할 수 있는지 기대하는 데서 그치지 않는 것입니다.
직접 실험하고, 어디서 실패하는지 확인하고, 그 실패를 관리할 수 있는 업무 구조를 만드는 것입니다.
AI를 잘 활용하는 조직은 AI 가능성을 이해하고, AI의 한계를 탐색해 가며, 그 오류를 극복할 수 있는 조직입니다.
댓글 0
첫 댓글을 남겨주세요.