피부자극반응(홍반) AI 판독모델 개발 및 운영 :AI가 배워야 할 ‘정답’을 함께 검증하는 일
 HS, HwangAIAX / DXTech이매진팩토리황현식
기존 업무에 AI를 적용하려면 현업 전문가의 경험과 판단이 필요합니다.
무엇을 평가해야 하는지, 어떤 차이가 중요한지, 결과를 어떻게 활용할 것인지는 그 일을 해온 사람들이 가장 잘 알고 있기 때문입니다.
그 판단 결과는 AI가 학습하고 평가받는 기준이 됩니다.
그런데 전문가가 만든 데이터라고 해서, 그 안의 모든 판단이 일관되게 이루어졌다고 전제할 수 있을까요?
이매진팩토리가 한 화장품 회사의 연구원들과 진행한 피부 홍반 판독 AI 과제에서는 이 질문을 함께 다뤘습니다.
기존 판독 업무를 디지털로 전환하고 효율화하는 과정에서,
알고리즘과 모델의 설정뿐 아니라 AI가 배워야 할 정답의 신뢰성까지 검증한 사례입니다.
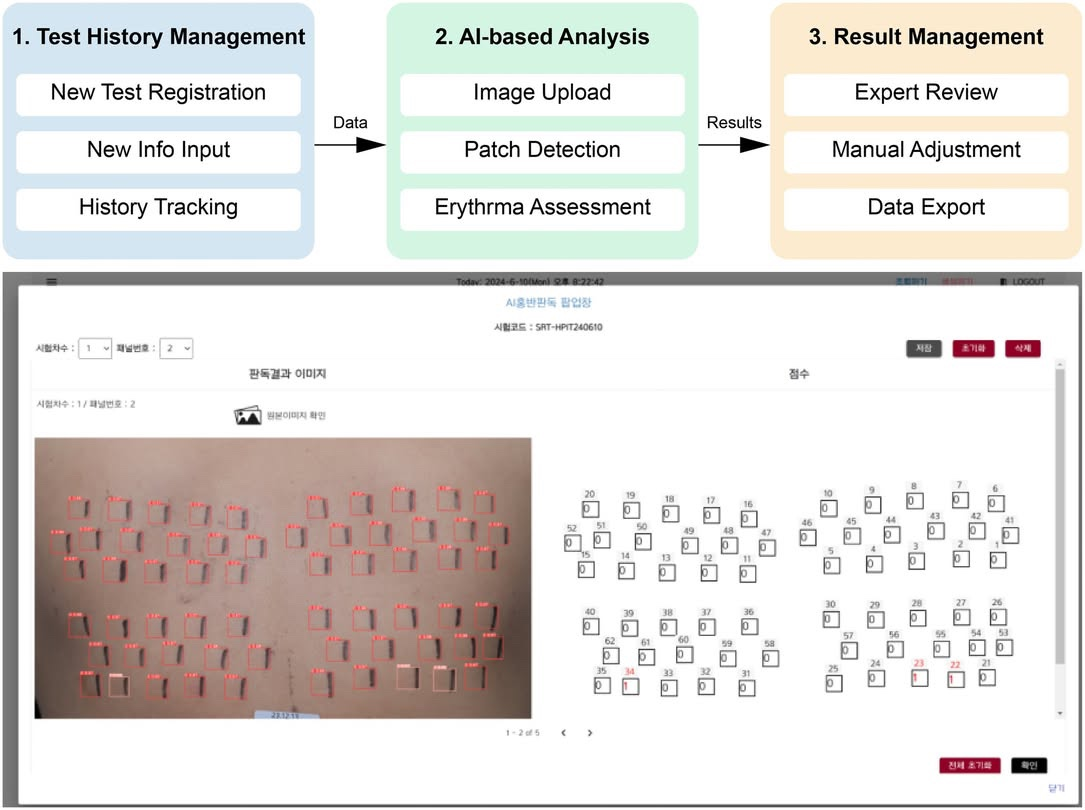
연구원의 판독 업무를 AI로 구현하기
화장품 안전성 시험에서는 피부에 나타나는 반응을 살펴보고 그 정도를 평가합니다. 이번 과제에서 다룬 홍반은 피부가 붉어지는 반응으로, 연구원들은 이를 관찰해 등급을 매깁니다.
과제의 목적은 연구원들이 수행하던 판독 업무를 디지털로 전환하고, AI를 활용해 더 효율적으로 수행할 수 있도록 하는 것이었습니다. 연구원들이 피부 사진에 매긴 점수를 정답 데이터로 삼아 모델을 학습시키고, AI의 판독 결과를 검증하며 성능을 개선했습니다.
모델의 예측이 연구원의 점수와 다를 때는 그 원인을 살펴봐야 합니다.
더 적합한 알고리즘을 찾거나, 하이퍼파라미터를 조정하거나, 학습 데이터를 보완하는 방법을 검토할 수 있습니다.
저희는 이러한 기술적 접근과 함께, 정답으로 사용하고 있는 연구원의 판단에도 질문을 던졌습니다.
같은 사진을 다른 연구원이 판독해도 같은 점수를 매길까요?
연구원들 사이에서 판단이 달라진다면, AI는 어떤 판단을 배우고 있는 것일까요?
같은 판독 기준을 사용하고 있다는 것과, 실제 사진에 그 기준을 일관되게 적용하고 있다는 것은 별도로 확인해야 할 문제였습니다.
AI와 연구원, 연구원과 연구원의 판단을 함께 비교하다
이를 확인하기 위해 같은 샘플을 여러 연구원이 각각 판독하도록 했습니다. 서로의 결과가 판단에 영향을 주지 않도록 블라인드 상태에서 평가했고, AI도 같은 샘플을 판독하게 했습니다.
분석에서는 두 가지를 함께 비교했습니다.
- AI와 연구원은 얼마나 같은 점수를 매기는가
- 연구원들끼리는 얼마나 같은 점수를 매기는가
단순히 점수가 같았던 비율만 확인하지는 않았습니다.
우연히 같은 등급을 매길 가능성을 보정하는 Fleiss’ kappa와,
반응의 정도에 대한 평가 순서가 얼마나 일관되는지 살펴보는 Kendall’s W를 활용해 평가자 간 신뢰도를 분석했습니다.
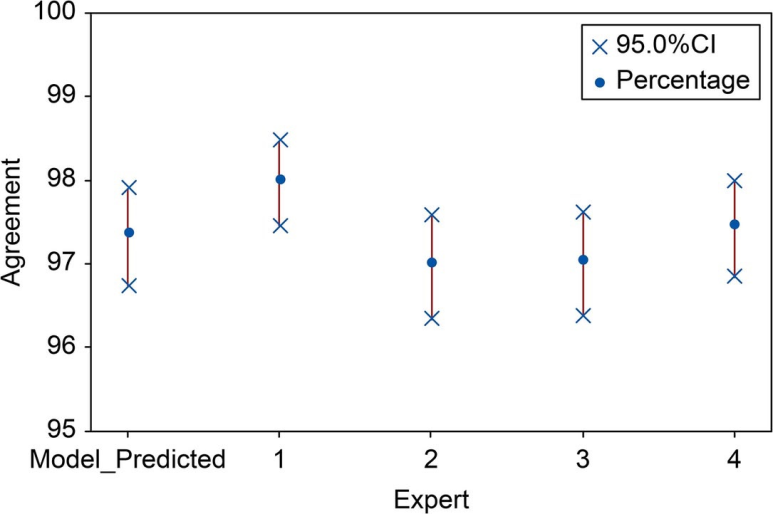
분석 결과, AI와 연구원의 판독이 일치하는 수준은 연구원들끼리 판독이 일치하는 수준과 비슷했습니다.
AI가 연구원의 판단을 제대로 따라오지 못한다고 생각했던 상황에서,
정답을 제시하는 연구원들끼리도 같은 사진에 서로 다른 점수를 매기고 있었던 것입니다.
이 결과는 모델의 오류를 해석하는 관점을 넓혀주었습니다.
AI의 점수가 특정 연구원의 점수와 다르다는 이유만으로 모델이 잘못 판단했다고 단정할 수는 없었습니다.
모델이 잘못 학습한 부분과 함께, 정답 데이터의 기준이 일관되게 적용되었는지도 검토해야 했습니다.
판독 기준을 맞추고, 학습 데이터를 다시 정비하다
연구원들은 비교 결과를 바탕으로 서로의 판독 기준을 맞췄습니다. 같은 피부 반응을 같은 등급으로 평가할 수 있도록 기준을 정비하고, 그 기준에 따라 학습 데이터의 점수도 다시 매겼습니다. 어노테이션을 다시 수행한 것입니다.
이렇게 정리한 데이터로 모델을 학습하니 성능도 크게 좋아졌습니다.
이 과정에서 통계 분석과 현업의 전문성은 서로 다른 역할을 했습니다. 분석은 판단이 얼마나 일치하고 어디에서 차이가 생기는지 검토할 근거를 제공했습니다. 그 차이를 해석하고, 어떤 기준으로 판독해야 하는지 정리하는 일에는 연구원들의 전문성이 필요했습니다.
이매진팩토리는 비교·검증할 근거를 마련하고 모델 개선을 함께 진행했습니다.
연구원들은 분석 결과를 받아들여 판독 기준과 데이터를 정비했습니다.
현업의 판단 기준, 학습 데이터의 일관성, 모델 성능을 연결해 개선한 과정이었습니다.
현장의 검증 경험을 연구로 연결하다
이 과제를 바탕으로 진행한 연구는 2025년 국제학술지 Contact Dermatitis에 발표됐습니다.
논문에서는 연구원과 AI의 판독을 비교한 3,072건 중 2,906건에서 점수가 일치해, 94.6%의 일치율을 보고했습니다.
논문
Evaluation of Artificial Intelligence-Assisted Diagnosis of Skin Erythema in a Patch Test
https://onlinelibrary.wiley.com/doi/10.1111/cod.70011
기존 업무를 AI로 전환하며 함께 살펴봐야 할 것
현업에서 쌓아온 경험과 판단은 AI 개발의 중요한 출발점입니다.
다만 그 결과를 정답 데이터로 사용하려면, 어떤 기준으로 만들어졌고 실제로 얼마나 일관되게 적용되었는지도 확인해야 합니다.
이번 과제에서는 알고리즘과 하이퍼파라미터를 최적화하는 것과 함께,
정답으로 받아들이던 판단을 다른 관점에서 살펴본 것이 개선의 중요한 계기가 됐습니다.
기존 판독 업무를 더 효율적으로 수행할 방법을 만드는 과정에서, 그 업무를 뒷받침하는 기준까지 검토할 수 있었습니다.
이매진팩토리는 AI를 현업에 적용할 때 기술 구현과 업무 이해를 함께 다룹니다.
모델의 결과를 분석하는 데서 멈추지 않고, 현업 담당자와 그 의미를 해석하고 실제 업무와 데이터를 개선하는 조치로 연결합니다.
AI가 기존의 일을 잘 수행하도록 만드는 과정에는,
우리가 그 일을 어떤 기준으로 해왔는지 함께 확인하는 일도 포함되어 있습니다.
댓글 0
첫 댓글을 남겨주세요.